
Neuartige Datenarchitektur, die AI Agents und Applikationen stets aktuellen Kontext für ihre Entscheidungen und Aktionen bereitstellt. Gemeinsame Grundlage für Entscheidungen und autonomes Handeln…
Hintergrund
Data Lakes, Data Warehouses und Lakehouses wurden in erster Linie für Reporting und andere Batch-Verarbeitungsprozesse entwickelt. Da AI Agents in Unternehmen zunehmend Aufgaben übernehmen, müssen sie Entscheidungen auf Basis von Informationen treffen, die über verschiedene Systeme verteilt sind und zu unterschiedlichen Zeitpunkten aktualisiert werden. Wenn diese Systeme unterschiedliche Sichtweisen auf den aktuellen Zustand des Unternehmens bieten, besteht die Gefahr, dass AI Agenten auf Grundlage veralteter oder widersprüchlicher Informationen handeln. Diese Aktionen können sich wiederum auf andere Arbeitsabläufe auswirken.
Ankündigungsübersicht
Confluent hat am 5. Nov. 2026 neue Funktionen für den Aufbau eines Streamhouse vorgestellt. Mit der allgemeinen Verfügbarkeit von Lightning Tables auf AWS vervollständigt Confluent nach vorliegenden Angaben seine Data Streaming Platform, die auf fünf zentralen Säulen basiert. Damit vereint die Plattform Funktionen zum Streamen, Verbinden, Verarbeiten, Verwalten und nun auch zur Datenabfrage in einer einheitlichen Lösung für den Aufbau eines Streamhouse. Confluent spielt eine zentrale Rolle in der Datenstrategie von IBM und kombiniert Echtzeit-Datenstreaming mit den Integrations-, Governance- und AI-Funktionen des Anbieters über hybride Umgebungen hinweg.
Wie ein Streamhouse in der Praxis funktionieren kann, soll das folgende Beispiel von Confluent für eine Fluggesellschaft verdeutlichen, die einen ausgefallenen Flug abwickeln muss:
„Heute verfügen verschiedene Systeme über widersprüchliche Informationen zu ein und demselben Vorgang. Das Flugbetriebssystem erfasst den aktuellen Standort des Flugzeugs, das Planungssystem verwaltet die Abflugzeiten und das Reservierungssystem zeigt die verfügbaren Sitzplätze an. Werden diese Systeme zu unterschiedlichen Zeitpunkten aktualisiert, kann ein autonomer AI Agents für Umbuchungen eine Reiseroute zusammenstellen, die in jedem einzelnen System gültig erscheint, in der Praxis jedoch nicht funktioniert: Ein Sitzplatz ist zwar verfügbar, aber das Flugzeug kann nicht rechtzeitig eintreffen, damit der Passagier seinen Anschlussflug erreicht. Kundenserviceteams und Benachrichtigungssysteme können anschließend auf Grundlage derselben widersprüchlichen Informationen handeln und so die Störungen weiter verstärken.
Mit einem Streamhouse kann jede Änderung dazu beitragen, ein gemeinsames, aktuelles Gesamtbild des Flugbetriebs zu schaffen. Ändert sich der Standort eines Flugzeugs, verzögert sich ein Abflug oder wird ein Sitzplatz gebucht, übermittelt das Quellsystem diese Aktualisierung in einen kontinuierlichen Event Stream. Ein Streamhouse führt diese Aktualisierungen zu einem aktuellen Geschäftskontext Zusammen und stellt ihn Umbuchungsagenten, Kundenserviceteams und Anwendungen während ihrer Arbeit zur Verfügung. Anstatt separate aktualisierte Informationen mühsam zusammenzuführen, können sie den Standort des Flugzeugs, die Abflugzeit und die Sitzplatzverfügbarkeit gemeinsam überprüfen, bevor sie einem Passagier eine neue Reiseroute anbieten.“
Ein weiteres Beispiel ist Accenture, das eine auf Confluent basierende Streamhouse-Architektur verwendet, um Daten über seine weltweiten Geschäftsbereiche hinweg miteinander zu verknüpfen. Anwenderkommentar (Auszug) Thomas Mahaffey, SAI Chief Data Strategist, Accenture: „Als weltweit tätiges Unternehmen mit Aktivitäten in mehr als 120 Ländern waren wir bisher durch veraltete Batch- und Punkt-zu-Punkt-Architekturen eingeschränkt. Die wiederholte Extraktion derselben Daten führte zu einem hohen operativen Aufwand, während Analysedaten nur verzögert zur Verfügung standen.
Durch den Umstieg auf eine Streamhouse-Architektur auf Basis von Confluent werden Datenproduzenten und -konsumenten voneinander entkoppelt. Dabei haben wir große Mengen an Event-Streams in verwaltete, wiederverwendbare Echtzeit-Datenprodukte umgewandelt, die nahtlos zwischen operativen und analytischen Systemen fließen. Da Confluent die Automatisierung der Infrastruktur übernimmt und eine nahtlose Vernetzung innerhalb des Unternehmens ermöglicht, arbeiten unsere Entwickler in einer standardisierten Umgebung, ohne individuelle Integrationen entwickeln oder Datenbewegungen bis ins kleinste Detail steuern zu müssen…“.
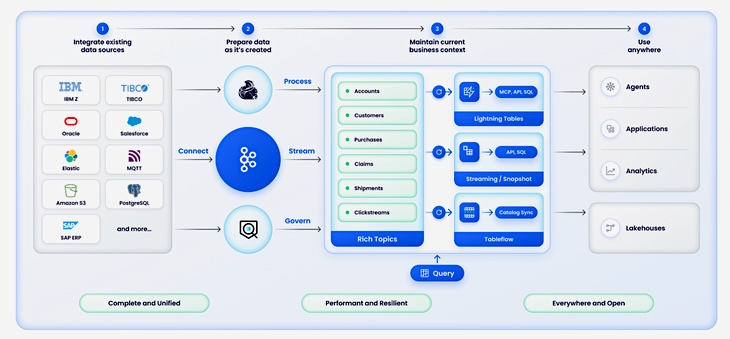
Bildquelle: Confluent, Data Streaming Platform (DSP).
Im Zentrum der Data Streaming Platform (DSP) steht Apache Kafka®, das Geschäftsereignisse erfasst und als Datenströme bereitstellt. Kafka allein reicht jedoch nicht aus, um diese Ereignisse in aktuellen Geschäftskontext umzuwandeln. Die DSP vereint laut Entwickler alle dafür erforderlichen Funktionen auf einer Plattform und ergänzt die bisherigen vier Säulen Stream, Connect, Process und Govern nun um Query als fünfte Säule. Zu den zentralen Funktionen und neuesten Erweiterungen der einzelnen Säulen gehören (Quelle, Anbieter):
“Stream” basiert auf Apache Kafka und der Kora-Engine und bietet eine skalierbare Grundlage für die Erfassung und das Streaming von Events über verschiedene Systeme hinweg. In internen Tests von Confluent wurden Latenzzeiten von unter einer Millisekunde erreicht. Die tatsächliche Latenz hängt von der jeweiligen Konfiguration und Arbeitslast ab.
“Connect” bietet über 150 vollständig verwaltete und individuell anpassbare Konnektoren, die Daten aus Unternehmenssystemen in Kafka integrieren und an nachgelagerte Systeme weiterleiten. Das hybride Management der Konnektoren erweitert die Möglichkeiten für Teams, diese Verbindungen zu verwalten.
“Process” nutzt Apache Flink, um Daten bei Veränderungen möglichst nah an der Quelle zusammenzuführen, anzureichern und daraus Geschäftskontext abzuleiten. Zusätzliche Funktionen zur Batch-Verarbeitung ermöglichen es, Streaming-Workloads auf Basis bestehender Daten zu initialisieren.
“Govern” unterstützt Teams dabei, Daten zu identifizieren, zu klassifizieren und abzusichern. Dafür stehen Funktionen für Data Lineage, Datenkatalogisierung, Datenqualität, Verschlüsselung, Schemaverwaltung und Zugriffskontrolle zur Verfügung.
“Query” stellt aktuellen Kontext für Analysen, AI Agents und Anwendungen; stellt dafür jeweils die passende Schnittstelle bereit.
"Confluent Tableflow" stellt Streaming-Daten für Lakehouses und Data Warehouses in offenen Tabellenformaten bereit, sodass sie direkt für Analysen genutzt werden können.
"Real-Time Context Engine" stellt AI Agents über das Model Context Protocol (MCP) aktuellen Kontext zur Verfügung.
"Lightning Tables" ermöglicht Anwendungen einen SQL- und API-Zugriff mit geringer Latenz auf den aktuellen Zustand des Unternehmens, sodass sie auf Veränderungen reagieren können."
Schneller Zugriff auf den aktuellen Zustand des Unternehmens
Lightning Tables ist laut Anbieter in Confluent Cloud auf AWS jetzt allgemein verfügbar. Als schreibgeschützter read-only-Layer speichert Lightning Tables Apache-Kafka-Daten dauerhaft und materialisiert sie in Tabellen, die bei Änderungen kontinuierlich aktualisiert werden. So wird der Zustand des Unternehmens für Abfragen mit geringer Latenz verfügbar gemacht. Zu den wichtigsten Vorteilen gehören (Quelle, Anbieter):
„Aktualität der Daten und Abfrageleistung: In internen Tests von Confluent vergingen zwischen der Erstellung neuer Daten und ihrer Bereitstellung etwa 100 Millisekunden. Die Abfragelatenz lag bei 10 bis 100 Millisekunden, bei einem Durchsatz von mehr als 1.000 Abfragen pro Sekunde.
Geringere Kosten und Komplexität: Eine vollständig verwaltete, kontinuierliche Bereitstellung von Daten, ohne dass separate ETL-Pipelines, Datenbanken oder Caches erforderlich sind.
Mehrere Abfrageschnittstellen: Daten können über SQL oder eine direkte API abgefragt werden.
Einheitliche Data Governance: Schemata, Data Lineage und Zugriffsrichtlinien können von der Datenerfassung bis zur Bereitstellung durchgängig angewendet werden.
Schema-Evolution: Schemaänderungen lassen sich verwalten, um Störungen in nachgelagerten Anwendungen zu vermeiden.
Feature Store: Features können mit Apache Flink berechnet und für Machine-Learning-Anwendungsfälle, einschließlich Echtzeit-Personalisierung, gespeichert werden."
Fazit
Ein Streamhouse basiert auf drei grundlegenden Architekturprinzipien: Aktualität, Zuverlässigkeit für geschäftskritische Anwendungen und Dezentralisierung. Es stellt kontinuierlich aktualisierten Geschäftskontext bereit, ist auf die Anforderungen des produktiven Betriebs ausgelegt und ermöglicht die Nutzung von Daten direkt dort, wo sie sich befinden, ohne dass diese zunächst zentral zusammengeführt werden müssen. Dabei ergänzt es bestehende Data Warehouses und Lakehouses um eine operative Echtzeitebene, die als Grundlage für Entscheidungen und Aktionen dient.
Querverweis:
Unser Beitrag > Schnellere Datenverarbeitung für KI-Workloads: Starburst Torin Vorstellung zur NVIDIA GTC Berlin 2026
Unser Beitrag > Vektorsuche mit MongoDB 9.0 und Atlas Infinite: KI-Anforderungen im großen Maßstab bedienen