
Kombiniert Supermicro Petascale-Storage-Server, IBM Storage Scale Software, Inferenzsoftware NVIDIA Dynamo sowie NVIDIA Spectrum-X-Ethernet-Switches. Reduzierte Time-to-First-Token…
Hintergrund
Leistungstests haben gezeigt, dass die vorgestellte KV-Cache-Lösung die Time-to-First-Token (TTFT) bei langen Kontextfenstern im Vergleich zu Systemen ohne KV- (Key-Value) Cache verkürzt. (1) Kunden sollen damit laut Entwickler die Effizienz der Inferenz durch eine höhere GPU-Auslastung, einen höheren Durchsatz und eine bessere Skalierbarkeit der Infrastruktur erheblich steigern können.
Ankündigungsübersicht
Am 6. November 2026 hat Super Micro Computer, Inc. gemeinsam mit IBM und NVIDIA die neue KV-Cache-Storage-Lösung vorgestellt. Als gemeinsame Lösung integriert Supermicro Petascale-All-Flash-Storage-Server mit Prozessoren der AMD EPYC 9005-Serie („Turin“), die Software IBM Storage Scale sowie die Inferenz-Framework-Software NVIDIA Dynamo und NVIDIA Spectrum-X-Ethernet-Netzwerktechnik. Stichwort: "High-Performance Software-Defined Storage for AI Workloads".
Zusammen sind die Technologien nach vorliegenden Informationen in der Lage, die Zeit, die KI-Modelle benötigen um mit der Generierung einer Antwort zu beginnen, drastisch zu verkürzen – ein wichtiger Vorteil, wenn Unternehmen zunehmend Agentic AI und KI-Workflows mit langem Kontext einsetzen.
Die Erweiterung der KV-Cache-Kapazität über den lokalen GPU-Speicher hinaus soll die GPU-Auslastung und den Inferenzdurchsatz verbessern und gleichzeitig eine hohe Verfügbarkeit der KV-Cache-Inhalte sowie eine unterbrechungsfreie Skalierung der KV-Cache-Kapazität ermöglichen können. Das Ergebnis ist laut den beteiligten Anbietern eine „skalierbarere, resilientere Inferenzarchitektur, die schnellere und reaktionsfähigere KI-Erlebnisse bietet.“
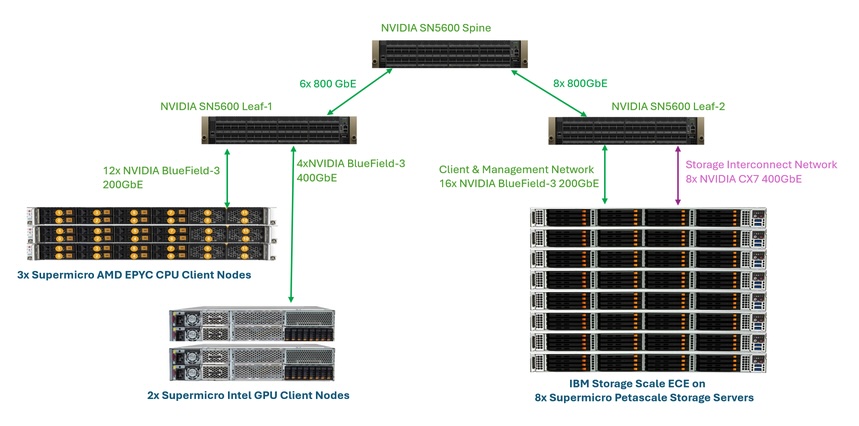
(1) Quelle / Abb.: KV cache benchmark setup with NVIDIA Dynamo, NVIDIA Spectrum-X, IBM Storage Scale, and Supermicro hardware (Bildquelle: IBM Redbook „Context without Limits: A High-Performance KV Cache Platform for Large-Scale AI Inference“).
Kommentarauszug Charles Liang, President und CEO von Supermicro: „Da sich KI-Workloads vom Training auf die Inferenz ausweiten, müssen Unternehmen und Neoclouds Engpässe beseitigen, um die GPU-Effizienz zu verbessern – vor allem, wenn sie Inferenz-Workloads mit hohem Durchsatz betreiben, wie sie für Agentic AI und generative KI mit langem Kontext und mehreren Interaktionsrunden typisch sind.“
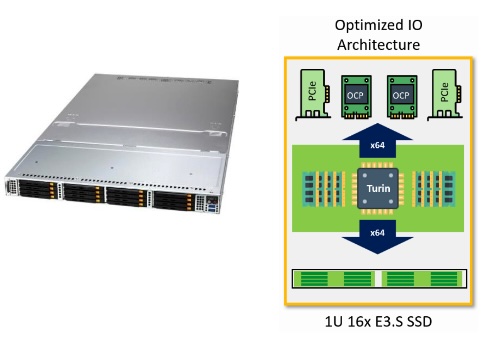
Abb.: Supermicro Petascale Storage Server and Internal I/O Architecture (Bildquelle: Solution Brief, Super Micro Computer, Inc.).
Weitere (technische) Ankündigungsdetails:
Inferenz-Workloads bestehen aus zwei Phasen: Prefill und Decode.
Während des Prefill-Vorgangs wird der Eingabetext in Token umgewandelt und vom LLM verarbeitet, um die für die Inferenz erforderlichen Key-Value-Zwischenzustände (KV-Zustände) zu erzeugen.
Durch die Speicherung dieser zuvor berechneten KV-Zustände in einem persistenten KV-Cache kann das System sie wiederverwenden, anstatt denselben Kontext für nachfolgende Anfragen neu zu berechnen.
Agentic-AI-Workflows, Programmierassistenten, RAG mit langem Kontext, multimodale KI und Anwendungen mit mehreren Interaktionsrunden können bei der Verarbeitung umfangreicher Codebasen, Dokumente, Konversationen, Bilder und anderer Kontextdaten erhebliche Mengen an KV-Zuständen erzeugen.
Dadurch wird die Kapazität des GPU- und CPU-Arbeitsspeichers schnell überschritten, und es entsteht die Notwendigkeit, den KV-Cache auf einen gemeinsam genutzten Netzwerk-Storage mit hoher Kapazität auszulagern. Die KV-Cache-Lösung von Supermicro, IBM und NVIDIA stellt diese persistente Storage-Schicht bereit.
Zu den wichtigsten Vorteilen der KV-Cache-Lösung zählen (Quelle, Anbieter):
„Gemeinsame Lösungsvalidierung – Supermicro, IBM und NVIDIA führten umfangreiche Tests auf Cluster-Ebene durch, um die Leistung zu messen, darunter Szenarien mit hoher Parallelität und „Noisy-Neighbor“-Netzwerkverkehr.
Deutlich schnellere und konsistentere Inferenzleistung – In gemeinsamen Tests von Supermicro und NVIDIA mit einem LLM mit 120 Milliarden Parametern lieferte der persistente KV-Cache bei Prompts mit 130.000 Token eine bis zu 56-mal kürzere TTFT. (1)
Bei einer Erhöhung der Eingabelänge von 30.000 auf 130.000 Token stieg die TTFT mit KV-Cache nur um 0,377 Sekunden, verglichen mit 29,55 Sekunden ohne KV-Cache, was eine konsistentere Leistung bei Workloads mit langem Kontext ermöglicht.
Höhere GPU-Auslastung und höherer Durchsatz – Indem häufig wiederverwendete Kontexte außerhalb des GPU-Speichers verfügbar gehalten werden, trägt die Lösung dazu bei, die Leerlaufzeit der GPU zu reduzieren, den Inferenzdurchsatz zu steigern und eine höhere Parallelität zu unterstützen, ohne die GPU-Ressourcen proportional zu erhöhen.
Resilienz auf Enterprise-Niveau und vertrauenswürdiger KI-Betrieb – Ein persistenter, hochverfügbarer KV-Cache trägt zum Schutz des zwischengespeicherten Inferenzzustands bei und ermöglicht gleichzeitig den gemeinsamen Zugriff über GPU-Knoten und Cluster hinweg, wodurch resilientere und Storage-effizientere KI-Dienste in großem Maßstab unterstützt werden.
Validierte, schlüsselfertige KI-Infrastruktur – die integrierte Architektur wurde gemeinsam in Szenarien mit hoher Parallelität und „Noisy-Neighbor“-Bedingungen validiert.
Beschleunigte Bereitstellungsdienste – Die werkseitige Rack-Integration und die Vor-Ort-Bereitstellungsdienste von Supermicro können die Bereitstellungszeit der Lösung von Wochen auf Tage verkürzen."
Querverweis:
Unser Beitrag > KI-Storage-Herausforderungen: Wie kann Speicherplatz im KV-Cache beim Einsatz großer Sprachmodelle und der Vektorsuche optimiert werden?
Unser Beitrag > Ethernet für KI-Storage und IT-Infrastruktur-Herausforderungen aus Speichernetzwerk-Sicht
Unser Beitrag > FMS Future of Memory and Storage 2026 (US): Messe-Übersicht mit Technologie- und Anbietertrends
Unser Blogpost mit Podcast: Moderne Speichersysteme als aktive Elemente zur Beschleunigung datenintensiver Workloads